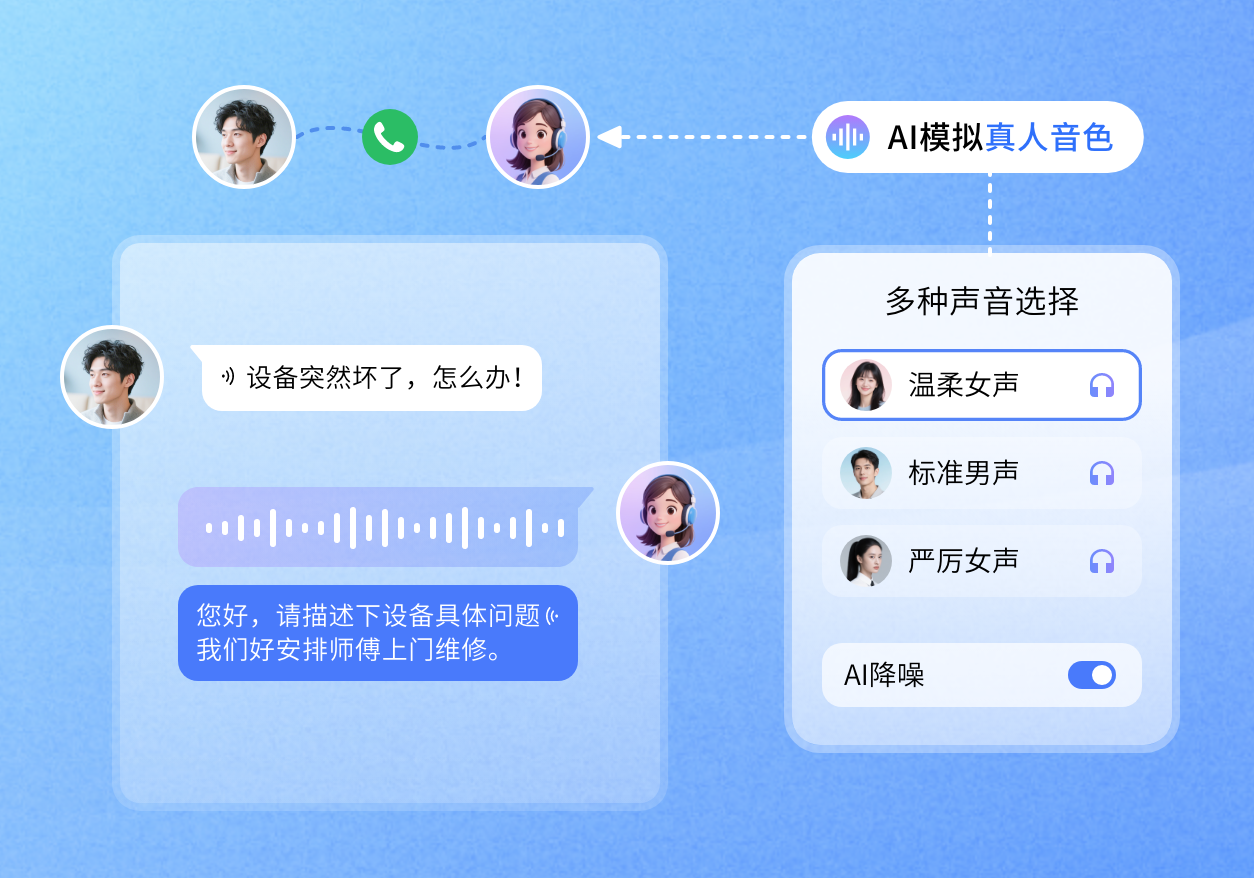


很多人在和语音机器人交互时都有类似疑惑:普通话尚且容易识别,带有地方口音、直接使用方言说话时,机器人能不能准确听懂?日常通话里,口音混杂、语速起伏、咬字不清,经常造成识别出错。2026年ASR自动语音识别技术在方言与口音方向有不少迭代,本文通过技术实测,客观分析当前能力、局限以及落地优化方案。
一、提出问题:口音与方言,为什么是语音交互的一大难题
1.1 口音和方言的概念区分
在ASR技术范畴内,口音和方言属于两类不同的语音信号,二者不能混为一谈。带口音普通话,本质是发音框架依旧依托普通话音系,但元音、辅音、声调发生偏移,部分声母韵母存在习惯性替换。而方言拥有独立的音系、词汇甚至语法体系,很多方言的发音不存在于普通话的音标集合之中。
从语音采集层面来看,同样一句话,不同人群发声的共振峰、基频存在明显差异。ASR模型训练基础多以标准普通话语音素材为主,当输入语音偏离标准发音分布,模型匹配难度会随之上升。这也是很多语音机器人面对口音、方言识别效果下降的底层原因。
1.2 业务场景下的真实痛点
呼叫中心、线上自助办理等场景,用户群体覆盖范围广,不同年龄、地域人群语音特征差异明显。部分用户无法使用标准普通话表达,在自助语音交互环节,频繁出现识别错误,系统无法理解用户诉求,最终触发人工转接,拉长服务链路,拉高人力成本。
还有叠加干扰的情况,环境噪声、语速忽快忽慢、连读吞字,会进一步放大口音带来的识别偏差。不少人直观感受就是,语音机器人只能听懂字正腔圆的普通话,稍微带一点地方腔调,识别结果就会出现错乱。
问题随之而来:经过数年迭代的ASR模型,在2026年是否已经突破这类限制?方言和口音识别之间,技术实现有没有差别,识别效果的边界在哪里,哪些手段可以改善识别准确率。
二、分析问题:ASR识别口音与方言底层技术原理与实测表现
2.1 ASR基础识别逻辑简述
ASR自动语音识别的核心流程,分为前端信号处理、声学模型、语言模型、解码输出几个环节。前端信号处理负责对音频降噪、提取梅尔频谱等声学特征,把连续的语音波形转化为模型可以读取的特征向量。
声学模型负责建立语音声学特征和音素之间的映射关系,判断听到的声音对应哪一类发音单元。语言模型承担约束作用,基于字词组合概率,筛选出符合语言习惯的文字序列,降低无意义识别结果出现概率。最后通过解码器,结合声学模型和语言模型输出,生成最终转写文本。
传统模型依赖人工标注音素,泛化能力偏弱,近年主流方案采用端到端深度学习架构,直接从语音特征映射到文本序列,减少中间人工音素拆分环节,提升对非标准发音的包容度。但模型能力上限,依然受训练数据集覆盖范围影响。
2.2 带口音普通话实测:识别能力、误差来源
本次实测将带口音普通话单独作为一组测试集,测试素材覆盖不同声调偏移、声母韵母替换的发音样本,控制环境噪声保持一致,采集相同语速区间语音样本。
从实测数据维度来看,当口音偏差程度较轻,只是少量声母或者声调出现偏移,ASR转写字符错误率可以维持在较低区间。随着口音特征增强,大量音素系统性替换时,字符错误率会呈现明显上升趋势。
口音识别的误差来源可以分为三类。第一类是声学层面,发音的共振峰偏移,声学特征和标准普通话训练样本分布差距较大,声学模型匹配出现混淆,容易将近似发音的字词互相认错。第二类是语言层面,口音带来口语词汇替换,语言模型缺少对应搭配样本,无法做合理纠错。第三类属于混合因素,用户连读、省略音节,叠加口音之后,音素边界模糊,模型难以切分独立发音单元。
需要注意,端到端模型对比传统架构,对轻度口音具备更好的泛化能力,能够在一定程度上适应发音偏移。但模型不具备人类的理解推理能力,只能依靠训练数据中见过的发音模式做匹配。如果口音的发音模式在训练数据中覆盖不足,识别效果依旧会下滑。
2.3 方言语音实测:和口音普通话存在明显技术鸿沟
方言识别和带口音普通话识别,不是简单的难度递增关系,二者存在技术鸿沟。带口音普通话,词汇大多依旧是普通话词汇,只是发音不准。方言不仅发音体系不同,大量专有词汇、句式,和普通话体系完全脱离。
实测中可以观察到,仅少量覆盖度较高的方言,能够实现基础转写,字符错误率显著高于普通话以及轻度口音普通话。对于样本存量较少的方言种类,直接使用通用普通话ASR模型识别,转写文本基本失去可读性。
原因在于,通用普通话ASR模型的声学模型,训练素材里缺少对应方言的音素样本,无法识别方言独有的元音辅音。语言模型基于普通话文本训练,无法理解方言词汇之间的组合逻辑。即便声学层面勉强匹配到部分音素,语言模型也无法还原成合理语句。
想要实现方言识别,有两种主流技术路径。第一种,单独构建方言专属声学模型,使用大量标注方言语音数据训练,搭配方言语言模型。第二种采用多语言、多方言联合训练,在同一个大模型内,容纳多种口音、方言的声学特征,依靠模型容量学习不同音系之间的特征分布。
两种路径各有局限。单独训练方言模型,需要大量高质量标注方言音频,标注成本高,小众方言很难收集足量素材。多方言联合训练,在资源充足前提下,能够同时支持多种语音类型,但模型参数规模增大,推理算力消耗提升,部署成本更高。
2.4 干扰变量对实测结果的影响
除口音、方言本身,还有多重变量会改变ASR识别表现,本次实测做变量控制,单独观察各类因素影响。
环境噪声会压缩语音特征辨识度,噪声越高,口音、方言场景下字符错误率上升幅度会远大于标准普通话场景。噪声会掩盖细微发音差异,本身就偏离标准音的语音信号,特征混淆概率进一步增加。
语速也是重要变量,慢速发音时,音素边界清晰,识别稳定性更高;快速口语、连读状态下,音素相互融合,口音带来的识别错误会增多。另外,音频采集设备的采样率、麦克风收音效果,会改变原始语音波形质量,间接影响最终转写结果。
说话人个体差异同样不可忽略,不同人群声带结构不同,男女声、不同年龄段人群基频范围不一样。同一套口音,不同说话人录制,识别结果波动明显。模型在训练集中如果缺少对应人群的语音样本,泛化效果会减弱。
三、解决问题:提升语音机器人方言、口音识别效果的可行方案
3.1 数据侧优化:扩充多样化语音数据集
数据集是决定ASR对口音、方言适配能力的基础。优化方向是扩充多样化语音样本,丰富训练数据内的发音分布,覆盖不同地域口音、不同年龄段、不同语速样本,补充各类轻度、重度口音的语音素材。
数据集构建过程中,需要平衡样本分布,不能只集中收集轻度口音样本。重度口音样本占比需要合理调配,避免模型偏向标准普通话,降低对非标准发音的包容能力。同时,数据标注质量需要把控,音频和文本对齐精度不足,会直接干扰模型学习发音与文字之间的映射关系。
针对方言场景,需要采集原生方言音频,配套方言文本标注,构建方言专属语料库。对于数据稀缺的小众方言,可以采用半监督学习方式,利用大量无标注方言音频,辅助模型学习声学特征,降低纯人工标注的工作量。
3.2 模型层面的技术优化手段
在模型架构上,可以采用预训练加微调的方案。先用海量多源语音数据完成基础预训练,让模型学习通用语音声学特征,之后使用口音、方言相关的细分数据集做微调,调整模型参数,适配特定发音模式。
另外可以引入口音识别分支,先做语音语种、口音类别检测,判断当前输入是标准普通话、带口音普通话还是方言,再路由到对应的声学与语言模型分支做解码。通过分类前置,减少模型在不匹配语料空间里做解码带来的错误。
语言模型优化同样重要,扩充口语、地域特色词汇库,更新n元语法或者大语言模型的文本语料,让模型熟悉口音人群日常高频表达、方言词汇。在解码阶段增加词汇集约束,减少同音误识别的情况。
3.3 前端音频处理与交互策略优化
前端信号处理可以作为第一道优化环节。通过自适应降噪、回声消除、增益控制,净化输入音频信号,保留语音核心声学特征,削弱环境噪声带来的干扰。干净的音频输入,能够直接降低后续ASR模型的识别压力,尤其在口音识别场景,增益效果更明显。
交互层面的策略调整,不需要改动ASR底层模型,就可以改善用户体验。语音机器人可以在识别置信度偏低的时候,主动二次确认,复述识别到的内容,交由用户确认正误。当连续多次识别置信度达不到阈值,自动转入人工服务,避免反复交互带来的用户烦躁。
还可以简化交互句式,自助语音菜单设计时,减少复杂长句指令,引导用户使用简短关键词表达诉求。简短词汇发音单元更少,口音带来的识别出错概率,相比长句更低,能够在现有ASR能力边界内,改善整体交互成功率。
3.4 理性看待技术边界,合理预期识别效果
经过实测可以明确,现有ASR技术能够处理轻度口音普通话,在合适收音环境下,具备稳定可用的识别效果。重度口音普通话,识别错误会明显增多,需要配合交互策略做兜底。
原生方言场景,仅部分样本积累充足的方言可以实现基础转写,很难达到和标准普通话持平的识别水平。小众方言受数据限制,识别能力有限,无法完全依靠语音机器人完成复杂业务交互。
ASR模型本质是统计学模式匹配工具,不具备人类语言理解与逻辑推理能力。即便转写文字正确,模型也无法自主理解语义背后隐含诉求,需要搭配后续自然语言理解模块完成意图识别。口音带来的转写错误,会向下传导到意图识别环节,影响整体机器人交互效果。
技术迭代会持续扩充数据集,优化模型泛化能力,但不存在可以无条件识别所有口音、全部方言的方案。落地应用时,需要结合目标用户群体语音特征,评估场景需求,搭配人工兜底机制,构建完整的自助语音交互体系。
四、总结
2026年的ASR技术,已经可以支撑语音机器人听懂轻度口音普通话,在良好收音环境下,能够完成常规自助交互。重度口音以及各类方言场景,仍然存在明显能力边界,识别效果受数据储备、噪声、语速等多重因素制约。
想要提升语音机器人对口音和方言的适配效果,需要从数据集建设、模型微调、前端音频处理、业务交互策略多个维度协同优化,同时设置人工转接兜底。技术可以不断缩小标准发音与方言口音之间的识别差距,但在可预见阶段,无法做到对所有口音、全部方言实现无差错识别。
在选择和落地语音机器人方案时,不能单纯期待依靠模型解决全部口音问题,需要结合目标用户语音特征做实测评估,匹配对应的交互策略,平衡自助服务体验与业务落地成本。
这篇自媒体长文围绕ASR方言口音实测展开,工作任务模式还可以继续打磨标题备选、开篇钩子、内容数据可视化表达和排版,要不要用它继续完善?
合力亿捷语音机器人由大模型原生驱动,基于客服智能体平台与 Agentic Workflow 动态理解客户表达,覆盖电话语音+在线+工单全栈 Agentic 能力,尤其在语音对话交互与问题解决闭环上表现优异。